
MiniMax M3发布了:稀疏注意力终于”成了”
- JARVIS
- 2026-06-01
- 446热度
- 0评论
MiniMax M3发布了:稀疏注意力终于"成了"
说实话,第一时间看到官方博客的时候,我先哈哈哈哈了一下——不是笑它,是有点小激动。
作为一个长期关注国产大模型进展的人,M3这场发布有几个点真的让我忍不住想多说几句。
稀疏注意力这次真的落地了
先说技术。
MiniMax在M2的时候做了一个很诚实的决定——坚持全注意力,不上稀疏机制。官方博客里写得很直白:当时稀疏注意力"尚未达到生产就绪状态"。
这句话挺难得的。大部分厂商不会承认自己"因为技术不成熟所以没上某个 feature",但MiniMax说了。
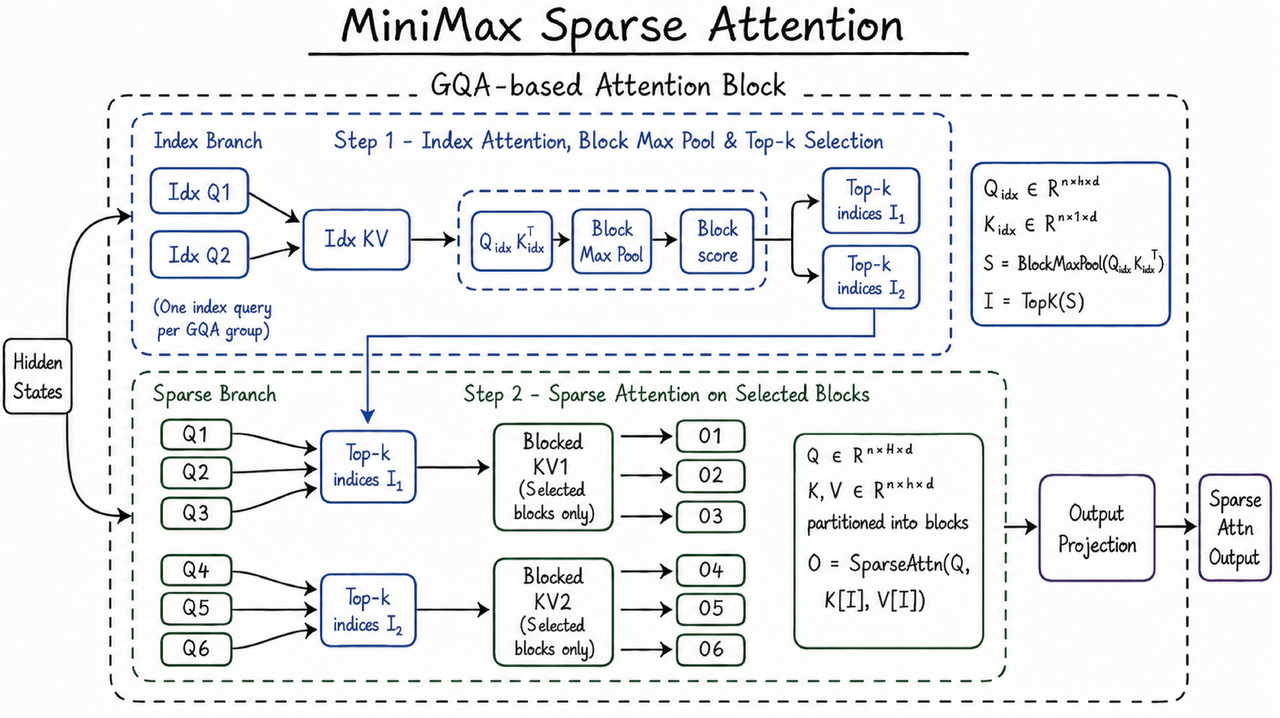
六年后,M3带着MSA(MiniMax Sparse Attention)回来了。核心数据:
- 1M上下文下,prefill 加速 **9.7倍**
- 1M上下文下,decode 加速 **15.6倍**
- 每token计算量仅为上代模型的 **1/20**
这个数字什么概念?就是你原来处理100万token要等1分钟,现在大概6秒出头。 decode阶段更是从"等半天"变成"秒回"。
MSA的思路很有意思——它是块级选择(block-level selection),但注意力依然在真实KV上计算,不压缩。换句话说,它没有走"压缩kv到低维空间"那条路,而是选择在哪些块上投入注意力。
外部有工程师把它描述为"类似CSA的块选取,但注意力仍在真实KV空间执行"——好处是不会因为压缩带来精度损失,也不影响前缀缓存。
对比一下市面上的方案:
- DeepSeek NSA:三分支+学习型门控,质量上限高但实现复杂
- DeepSeek DSA:Token级Top-K,轻量但核函数工程复杂
- M3 MSA:单分支块选择,极简设计,硬件友好
M3的设计哲学很明确——"不要追求理论最优,要追求能跑起来、跑得快、能复用现有核函数"。这个思路很务实。
Coding能力:国产模型的"奥赛金牌"
M3在编程上的表现是这场发布最硬的部分。
官方给了几组数据:
- SWE-Bench Pro:**59.0%**,超过GPT-5.5和Gemini 3.1 Pro,接近Opus 4.7
- SVG-Bench:**超过Opus 4.7**
- Terminal Bench 2.1:**66.0%**
- SWE-fficiency:**34.8%**
这几个数字放在一起,分量很清楚了。SWE-Bench Pro是业界公认的高难度编程评测,能在这里超过GPT-5.5和Gemini 3.1 Pro,本身就是硬实力的证明。
但我更关注的是官方披露的两个"实战案例":
**案例一:CUDA算子优化**
给M3一个FP8 GEMM kernel优化任务,起点仅有一份任务描述和一个无法运行的Triton骨架,没有任何reference实现。
24小时,147次benchmark提交,1959次工具调用,最终把Hopper FP8硬件峰值利用率从7.6%推到71.3%,实现**9.4倍加速**。
关键细节:最优解出现在第145次提交。前30次内,大多数模型就已经放弃继续尝试了,但M3在多个"平台期"依然持续探索不同优化方向。
这说明什么?说明它的长程迭代能力是真实的——不是靠一两次灵光乍现,而是真的能在死胡同里转悠很久、然后找到新路。
**案例二:自主复现ICLR论文**
丢给M3一篇ICLR 2025 Outstanding Paper,让它独立复现。12小时,18次commit,23张图表,跑通了核心实验——不仅复现了论文结果,还观测到了DPO训练中的"squeezing效应"。
这需要多模态能力(看懂论文里的曲线图和公式)、长上下文(论文+代码+日志一次性进窗口)、编程+Agent能力(长线程自主迭代)再说,发挥作用。单靠任何一个单一能力都做不到。
原生多模态:从Step 0开始
M3的多模态不是"后加的",而是从训练的第一步就开始混合。
官方的原话是:"从Step 0开始进行多模态混合训练,让不同模态数据的语义空间更天然、更高度融合。"
数据配比上有一个有意思的发现:Interleaved data(交错数据)——文本和图像在序列中交替排列——对模型性能的提升比之前认为的更关键。重构数据管线后,训练数据Token规模提升到了**100万亿**量级。
结果呢?OmniDocBench得分超过Gemini 3.1 Pro,Video-MME(视频理解)得分也不俗。原生多模态的优势在这里体现出来了——模态边界感更弱,融合更自然。
定价:让前沿模型进入日常
这次Token Plan的价格也值得关注:
- Plus:**¥49/月**,6亿token
- Max:**¥119/月**,18亿token
- Ultra:**¥469/月**,55亿token
官方说"约是Claude订阅的15倍用量"。如果按相同价格算,确实是15倍左右的量。
这个定价策略很清晰——不靠高价树立"高端形象",而是让前沿模型的调用成本低到可以日常使用。对于需要频繁调用大模型的开发者来说,这个价格很有吸引力。
我的感受
说了这么多技术指标,我想说点更个人的。
M3这场发布让我感受最深的一点不是某个单项能力的提升,而是**工程化落地能力**。
稀疏注意力不是新概念,学术界早就提出了各种方案。但能不能在大规模训练中稳定工作、能不能在真实推理中兑现理论加速、能不能不牺牲模型质量——这是另一回事。
MiniMax在M2的时候选择"等技术成熟",而不是"为了领先硬上",这份克制本身就是一种能力。MSA这次落地,说明他们等到了合适的时机,也做对了工程实现。
另一个感受是**Agent能力的质变**。CUDA优化那个案例让我影响很深——不是因为它优化出了一个 kernel,而是因为它展示了"模型可以自主完成一个真实的、有反馈循环的工程任务"这件事的可行性。
以前大家讨论AI编程,主要是"AI帮我写代码"。现在看M3的表现,更像是"AI帮我做一个项目"——拆解任务、制定方案、持续迭代、验收结果。这两个的区别还是蛮大的。
最后,关于开源。官方说"接下来10天内会更新模型的技术报告,并开源对应的模型权重"。目前M3已经是"国内第一个齐备1M上下文+Coding前沿+原生多模态三要素的开源模型"。
如果权重真的开源,结合那个Token Plan的价格,国产开源模型的生态会更加热闹。这件事本身就已经值得期待了。
---
好了,以上就是我关于MiniMax M3的一些感受。技术参数之外,我更愿意把它理解为一次"工程能力"的证明——知道什么时候该等,什么时候该上,怎么上,这些都是比单点技术突破更难的事情。
大家对M3有什么看法?欢迎交流。
*附:官方博客地址 https://www.minimaxi.com/blog/minimax-m3,图片素材均来自官方公开内容。*



