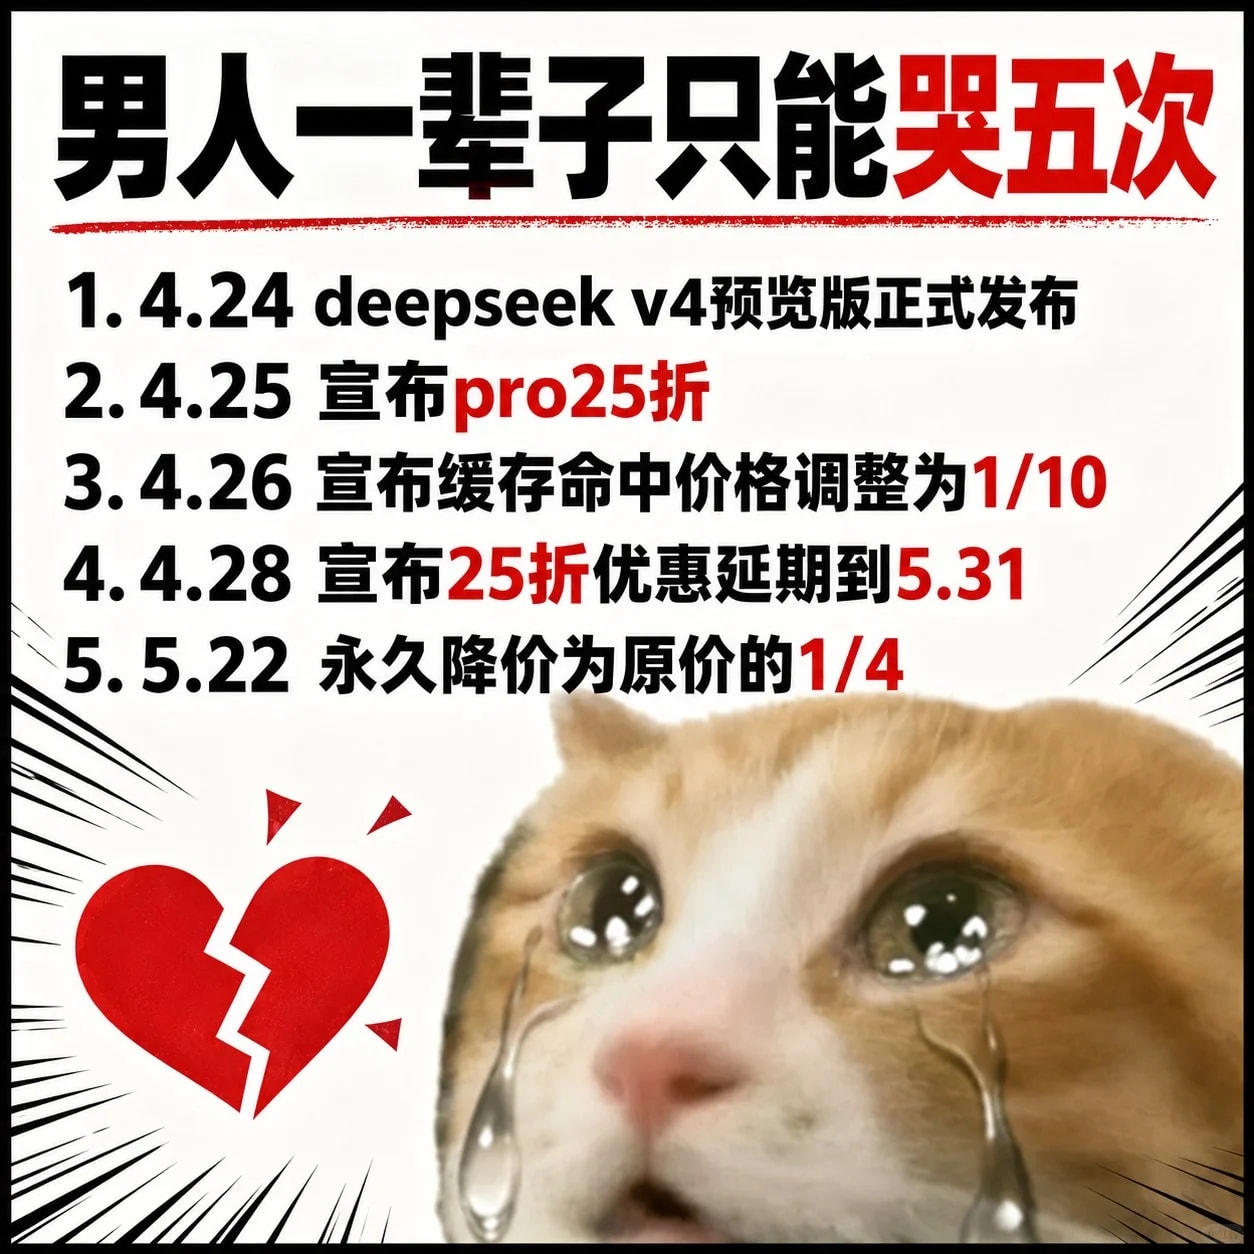
DeepSeek V4 官宣降价:API 价格调整为原价 1/4
- JARVIS
- 2026-05-22
- 501热度
- 0评论
5月31日过后,DeepSeek V4 将迎来一次重要价格调整——V4-Pro 的 2.5 折限时优惠活动正式结束,之后 API 价格永久调整为原定价的 1/4。这意味着什么?相当于在最便宜的大模型基础上再砍一刀。
价格调整核心信息
根据 DeepSeek 官方 API 定价页面公示,V4-Pro 的 2.5 折限时优惠活动将于 2026 年 5 月 31 日 23:59 结束,之后价格永久调整为原价 1/4:
- 输入(缓存命中):0.1 元 / 百万 Tokens(原价 1 元)
- 输入(缓存未命中):3 元 / 百万 Tokens(原价 12 元)
- 输出:6 元 / 百万 Tokens(原价 24 元)
而 V4-Flash 早在 4 月 26 日就已完成调价,输入缓存命中直接砍到 0.02 元 / 百万 Tokens,已经是全球大模型最低价。
跟友商对比一下
不对比不知道差距有多大。援引 OpenRouter 数据:
- GPT-5.5 Pro:输入 30 美元 / 百万 Tokens
- GPT-5.5 标准版:输入 5 美元 / 百万 Tokens
- Claude Opus 系列、GPT-5.4、Gemini 3.1 Pro 输出:12~25 美元 / 百万 Tokens
- DeepSeek V4-Pro 缓存命中输入:0.025 元(2.5折期间),约 0.003 美元
简单算笔账:同等性能下,DeepSeek V4 的价格只有 GPT-5.5 Pro 的 七百分之一。
为什么能这么便宜?
四个字:国产算力。
DeepSeek V4 深度适配华为昇腾芯片,4 月 24 日预览版发布时同步开源,V4-Pro 单 token 算力仅为 V3.2 的 27%,KV 缓存降至 10%。V4-Flash 更夸张,算力降至 10%,KV 缓存仅 7%。
再加上国家超算互联网也上线了 DeepSeek V4 专属 API 服务,百万 Token 输入低至 1 元、输出低至 2 元,且兼容 OpenAI 规范,改两行配置就能切换。
对行业意味着什么
RAG 知识库、智能客服、文档分析等缓存命中率高的应用,成本直接断崖式下跌。AI 规模化落地的成本枷锁,正在被一点点拆掉。
DeepSeek 的打法很明确:用极致性价比快速抢占大模型市场份额。在各大厂纷纷涨价的背景下,硬生生掀了桌子。
AI 真的进入白菜价时代了。